Article / 文章
LeetCode 第133题:克隆图
给你无向 连通 图中一个节点的引用,请你返回该图的 深拷贝(克隆)。 图中的每个节点都包含它的值 val(int) 和其邻居的列表(list[Node])。 class Node { public int val; public List neighbors; } 测试用例格式: 简单起见,每个节点的值都和它的索引相同。例如,第一个节点值为 1(val =
题目描述
给你无向 连通 图中一个节点的引用,请你返回该图的 深拷贝(克隆)。
图中的每个节点都包含它的值 val(int) 和其邻居的列表(list[Node])。
class Node {
    public int val;
    public List<Node> neighbors;
}
测试用例格式:
简单起见,每个节点的值都和它的索引相同。例如,第一个节点值为 1(val = 1),第二个节点值为 2(val = 2),以此类推。该图在测试用例中使用邻接列表表示。
邻接列表 是用于表示有限图的无序列表的集合。每个列表都描述了图中节点的邻居集。
给定节点将始终是图中的第一个节点(值为 1)。你必须将 给定节点的拷贝 作为对克隆图的引用返回。
难度
中等
题目链接
示例
示例 1:
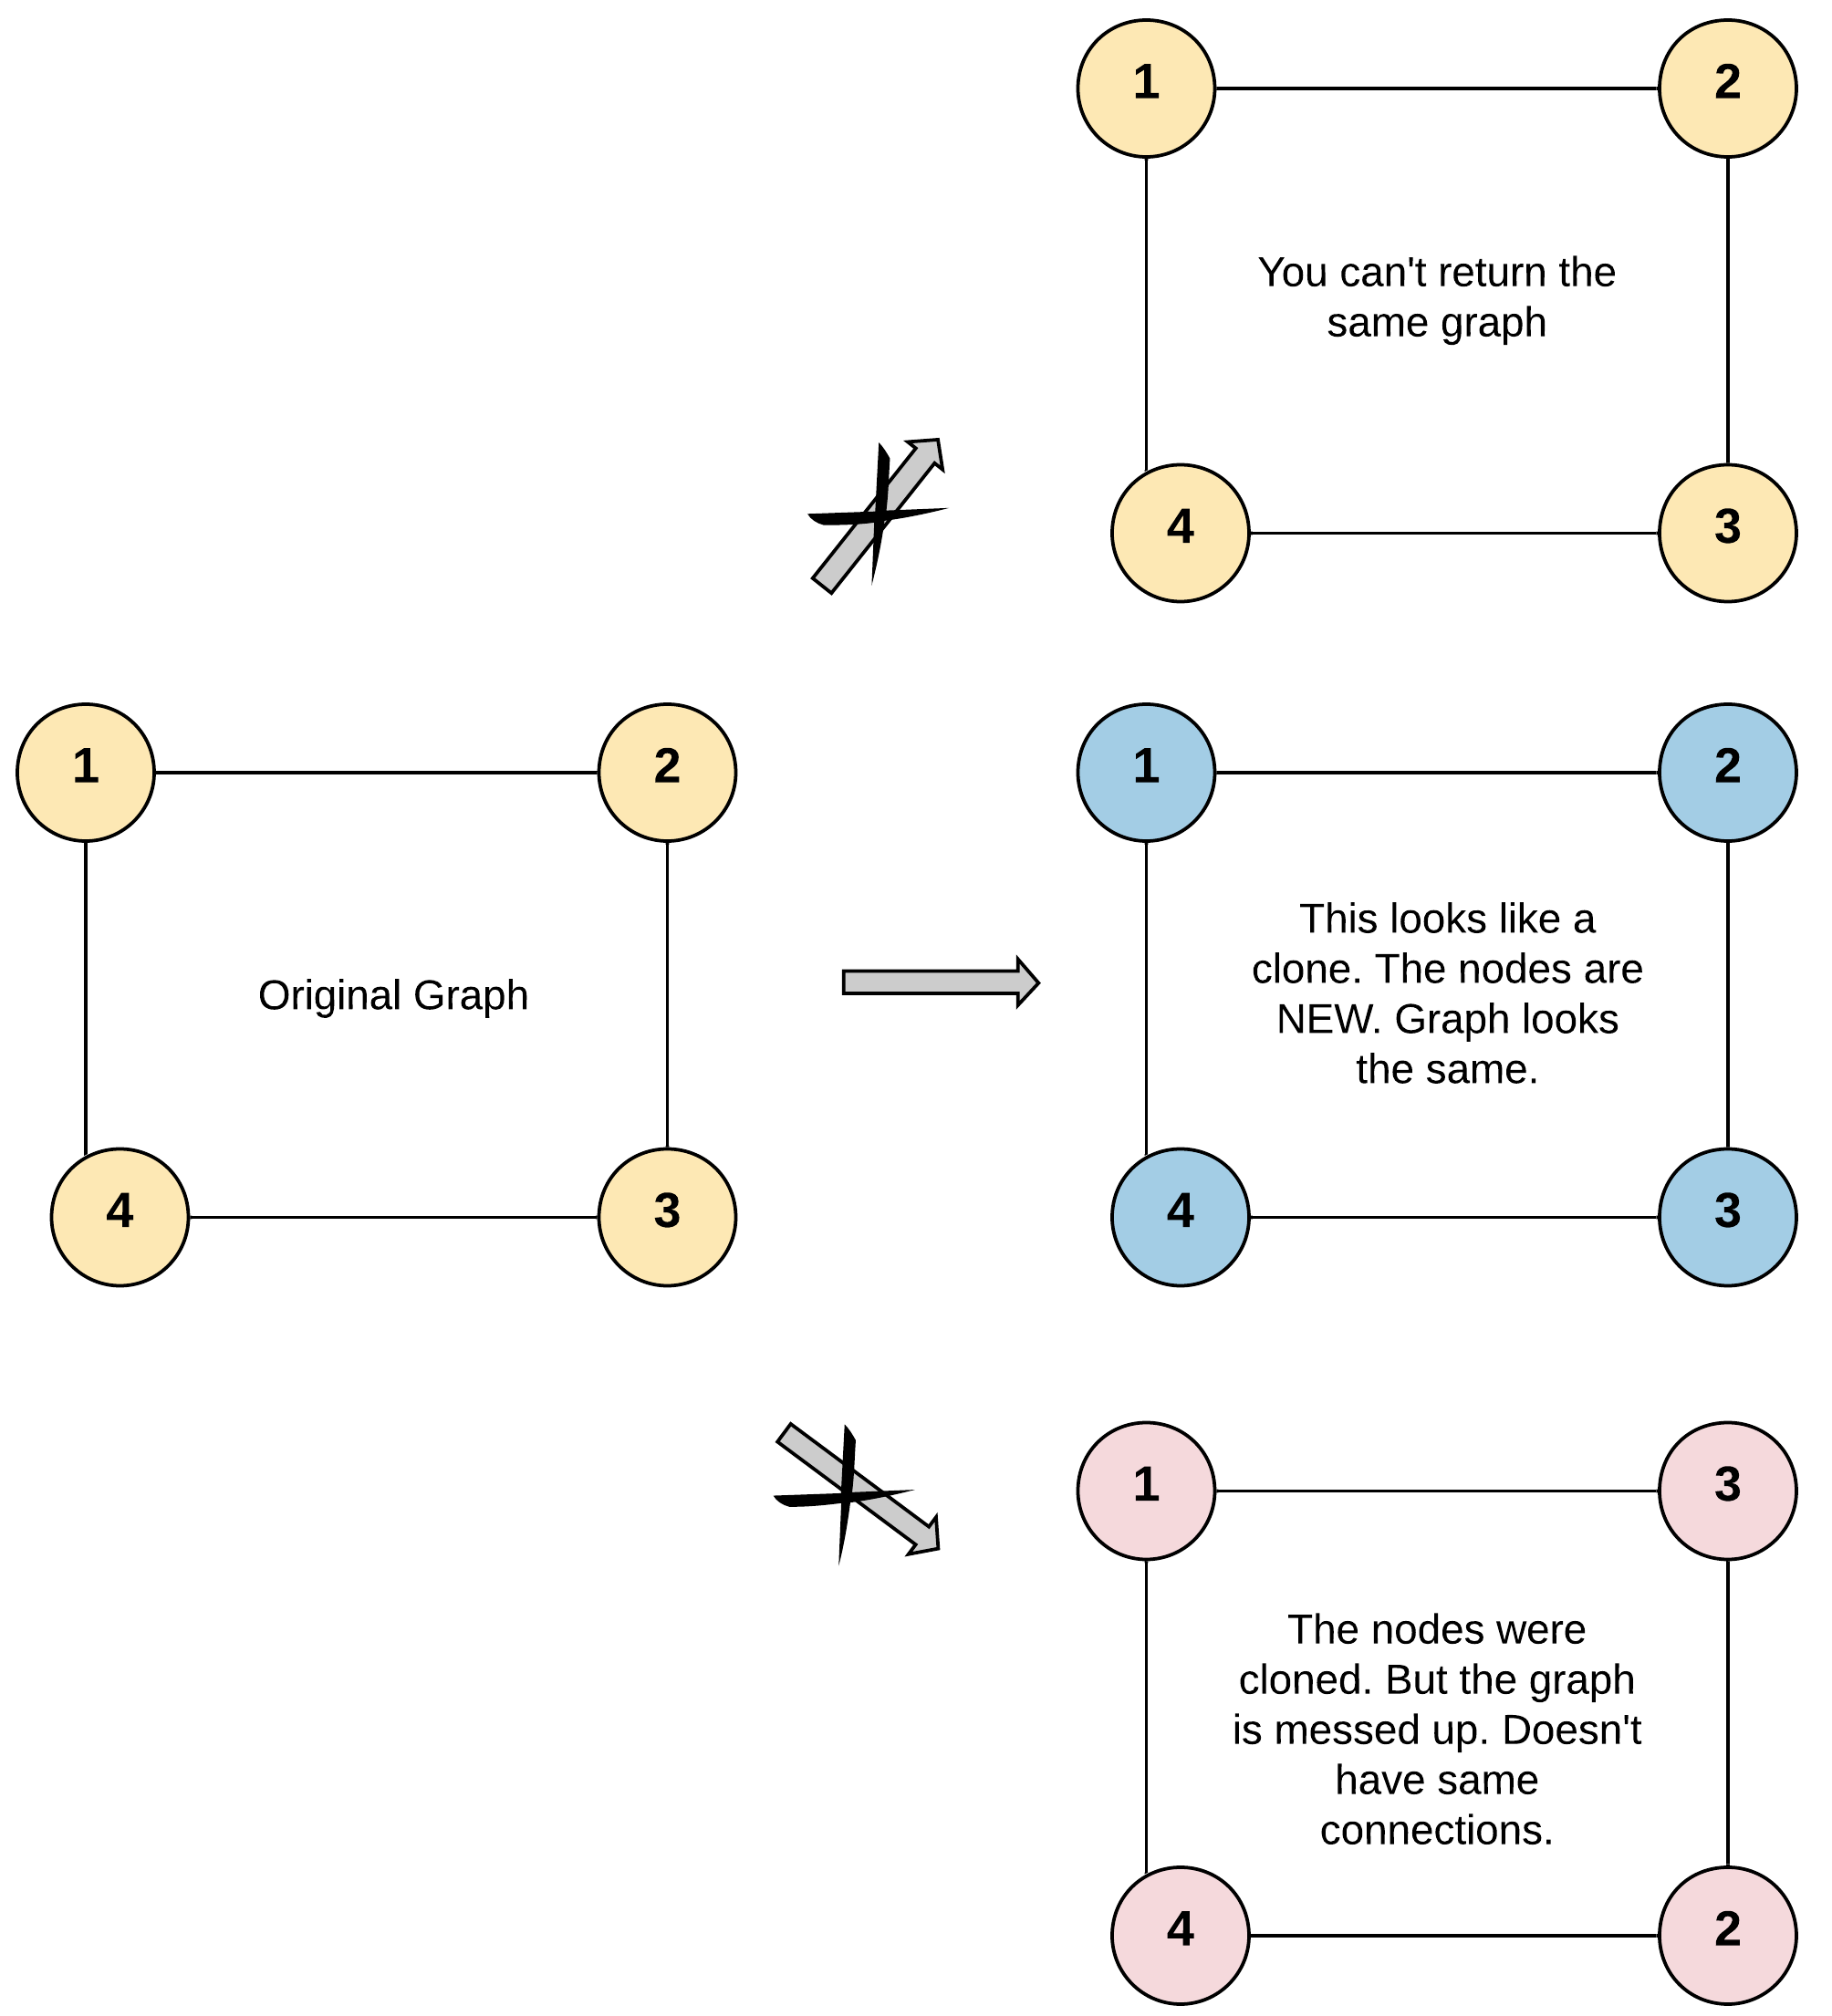
输入:adjList = [[2,4],[1,3],[2,4],[1,3]]
输出:[[2,4],[1,3],[2,4],[1,3]]
解释:
图中有 4 个节点。
节点 1 的值是 1,它有两个邻居:节点 2 和 4 。
节点 2 的值是 2,它有两个邻居:节点 1 和 3 。
节点 3 的值是 3,它有两个邻居:节点 2 和 4 。
节点 4 的值是 4,它有两个邻居:节点 1 和 3 。
示例 2:
输入:adjList = [[]]
输出:[[]]
解释:输入包含一个空列表。该图仅仅只有一个值为 1 的节点,它没有任何邻居。
示例 3:
输入:adjList = []
输出:[]
解释:这个图是空的,它不含任何节点。
示例 4:
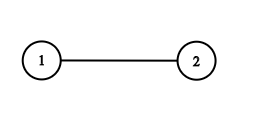
输入:adjList = [[2],[1]]
输出:[[2],[1]]
提示
- 节点数不超过 100 。
- 每个节点值
Node.val都是唯一的,1 <= Node.val <= 100。 - 无向图是一个简单图,这意味着图中没有重复的边,也没有自环。
- 由于图是无向的,如果节点 p 是节点 q 的邻居,那么节点 q 也必须是节点 p 的邻居。
- 图是连通图,你可以从给定节点访问到所有节点。
解题思路
方法一:深度优先搜索(DFS)
这道题要求我们克隆一个无向连通图。我们可以使用深度优先搜索(DFS)来遍历原图,同时构建新图。
关键点:
- 使用哈希表记录已经克隆过的节点,避免重复克隆
- 使用递归实现深度优先搜索
- 先克隆当前节点,再克隆其邻居节点
具体步骤:
- 创建一个哈希表visited,用于存储原图中的节点到新图中对应节点的映射
- 定义一个递归函数dfs(node),用于克隆以node为起点的子图
- 如果node为空,返回null
- 如果node已经被访问过(在visited中),返回对应的克隆节点
- 创建node的克隆节点cloneNode,并将映射关系存入visited
- 遍历node的所有邻居,对每个邻居递归调用dfs,并将结果添加到cloneNode的邻居列表中
- 返回cloneNode
- 调用dfs(node),返回克隆图的起始节点
时间复杂度:O(N + M),其中N是节点数,M是边数。需要遍历所有节点和边。 空间复杂度:O(N),需要使用哈希表存储所有节点的映射关系,以及递归调用栈的空间。
方法二:广度优先搜索(BFS)
我们也可以使用广度优先搜索(BFS)来遍历原图,同时构建新图。
关键点:
- 使用哈希表记录已经克隆过的节点,避免重复克隆
- 使用队列实现广度优先搜索
- 先克隆当前节点,再克隆其邻居节点
具体步骤:
- 如果起始节点为空,返回null
- 创建一个哈希表visited,用于存储原图中的节点到新图中对应节点的映射
- 创建起始节点的克隆节点,并将映射关系存入visited
- 创建一个队列,将起始节点加入队列
- 进行BFS:
- 从队列中取出一个节点node
- 遍历node的所有邻居neighbor:
- 如果neighbor没有被访问过,创建其克隆节点,并将映射关系存入visited,然后将neighbor加入队列
- 将neighbor的克隆节点添加到node的克隆节点的邻居列表中
- 返回起始节点的克隆节点
时间复杂度:O(N + M),其中N是节点数,M是边数。需要遍历所有节点和边。 空间复杂度:O(N),需要使用哈希表存储所有节点的映射关系,以及队列的空间。
图解思路
DFS克隆过程分析表
以示例1为例:
| 当前节点 | 操作 | 已访问节点 | 克隆图状态 |
|---|---|---|---|
| 节点1 | 创建克隆节点1’ | {1 -> 1’} | 1’ |
| 节点1的邻居:节点2 | 创建克隆节点2’,添加到1’的邻居 | {1 -> 1’, 2 -> 2’} | 1’ – 2’ |
| 节点2的邻居:节点1 | 已访问,添加1’到2’的邻居 | {1 -> 1’, 2 -> 2’} | 1’ – 2’ |
| 节点2的邻居:节点3 | 创建克隆节点3’,添加到2’的邻居 | {1 -> 1’, 2 -> 2’, 3 -> 3’} | 1’ – 2’ – 3’ |
| 节点3的邻居:节点2 | 已访问,添加2’到3’的邻居 | {1 -> 1’, 2 -> 2’, 3 -> 3’} | 1’ – 2’ – 3’ |
| 节点3的邻居:节点4 | 创建克隆节点4’,添加到3’的邻居 | {1 -> 1’, 2 -> 2’, 3 -> 3’, 4 -> 4’} | 1’ – 2’ – 3’ – 4’ |
| 节点4的邻居:节点1 | 已访问,添加1’到4’的邻居 | {1 -> 1’, 2 -> 2’, 3 -> 3’, 4 -> 4’} | 1’ – 2’ – 3’ – 4’ |
| 节点4的邻居:节点3 | 已访问,添加3’到4’的邻居 | {1 -> 1’, 2 -> 2’, 3 -> 3’, 4 -> 4’} | 1’ – 2’ – 3’ – 4’ |
| 节点1的邻居:节点4 | 已访问,添加4’到1’的邻居 | {1 -> 1’, 2 -> 2’, 3 -> 3’, 4 -> 4’} | 完整克隆图 |
BFS克隆过程分析表
以示例1为例:
| 队列 | 当前节点 | 操作 | 已访问节点 | 克隆图状态 |
|---|---|---|---|---|
| [1] | - | 初始状态 | {1 -> 1’} | 1’ |
| [] | 1 | 处理节点1 | {1 -> 1’} | 1’ |
| [2, 4] | 1 | 添加节点1的邻居到队列 | {1 -> 1’, 2 -> 2’, 4 -> 4’} | 1’ – 2’, 1’ – 4’ |
| [4] | 2 | 处理节点2 | {1 -> 1’, 2 -> 2’, 4 -> 4’} | 1’ – 2’, 1’ – 4’ |
| [4, 3] | 2 | 添加节点2的邻居到队列 | {1 -> 1’, 2 -> 2’, 4 -> 4’, 3 -> 3’} | 1’ – 2’ – 3’, 1’ – 4’ |
| [3] | 4 | 处理节点4 | {1 -> 1’, 2 -> 2’, 4 -> 4’, 3 -> 3’} | 1’ – 2’ – 3’, 1’ – 4’ |
| [3] | 4 | 添加节点4的邻居到队列(节点1和3已访问) | {1 -> 1’, 2 -> 2’, 4 -> 4’, 3 -> 3’} | 1’ – 2’ – 3’, 1’ – 4’ – 3’ |
| [] | 3 | 处理节点3 | {1 -> 1’, 2 -> 2’, 4 -> 4’, 3 -> 3’} | 1’ – 2’ – 3’, 1’ – 4’ – 3’ |
| [] | 3 | 添加节点3的邻居到队列(节点2和4已访问) | {1 -> 1’, 2 -> 2’, 4 -> 4’, 3 -> 3’} | 1’ – 2’ – 3’ – 4’, 1’ – 4’ – 3’ – 2’ |
代码实现
C# 实现
/*
// Definition for a Node.
public class Node {
    public int val;
    public IList<Node> neighbors;

    public Node() {
        val = 0;
        neighbors = new List<Node>();
    }

    public Node(int _val) {
        val = _val;
        neighbors = new List<Node>();
    }

    public Node(int _val, List<Node> _neighbors) {
        val = _val;
        neighbors = _neighbors;
    }
}
*/

public class Solution {
    private Dictionary<Node, Node> visited = new Dictionary<Node, Node>();

    public Node CloneGraph(Node node) {
        if (node == null) {
            return null;
        }

        // 如果该节点已经被访问过,则直接从哈希表中取出对应的克隆节点返回
        if (visited.ContainsKey(node)) {
            return visited[node];
        }

        // 创建克隆节点
        Node cloneNode = new Node(node.val, new List<Node>());

        // 将原始节点到克隆节点的映射存入哈希表
        visited.Add(node, cloneNode);

        // 遍历原始节点的邻居,并克隆它们
        foreach (Node neighbor in node.neighbors) {
            cloneNode.neighbors.Add(CloneGraph(neighbor));
        }

        return cloneNode;
    }
}
Python 实现
"""
# Definition for a Node.
class Node:
    def __init__(self, val = 0, neighbors = None):
        self.val = val
        self.neighbors = neighbors if neighbors is not None else []
"""

class Solution:
    def cloneGraph(self, node: 'Node') -> 'Node':
        if not node:
            return None

        # 使用字典存储已经克隆过的节点
        visited = {}

        # DFS方法
        def dfs(node):
            # 如果节点已经被访问过,则直接返回对应的克隆节点
            if node in visited:
                return visited[node]

            # 创建克隆节点
            clone_node = Node(node.val, [])

            # 将原始节点到克隆节点的映射存入字典
            visited[node] = clone_node

            # 遍历原始节点的邻居,并克隆它们
            for neighbor in node.neighbors:
                clone_node.neighbors.append(dfs(neighbor))

            return clone_node

        return dfs(node)
C++ 实现
/*
// Definition for a Node.
class Node {
public:
    int val;
    vector<Node*> neighbors;

    Node() {
        val = 0;
        neighbors = vector<Node*>();
    }

    Node(int _val) {
        val = _val;
        neighbors = vector<Node*>();
    }

    Node(int _val, vector<Node*> _neighbors) {
        val = _val;
        neighbors = _neighbors;
    }
};
*/

class Solution {
public:
    Node* cloneGraph(Node* node) {
        if (!node) {
            return nullptr;
        }

        // 使用哈希表存储已经克隆过的节点
        unordered_map<Node*, Node*> visited;

        // DFS方法
        function<Node*(Node*)> dfs = [&](Node* node) -> Node* {
            // 如果节点已经被访问过,则直接返回对应的克隆节点
            if (visited.count(node)) {
                return visited[node];
            }

            // 创建克隆节点
            Node* cloneNode = new Node(node->val);

            // 将原始节点到克隆节点的映射存入哈希表
            visited[node] = cloneNode;

            // 遍历原始节点的邻居,并克隆它们
            for (Node* neighbor : node->neighbors) {
                cloneNode->neighbors.push_back(dfs(neighbor));
            }

            return cloneNode;
        };

        return dfs(node);
    }
};
执行结果
C# 实现
- 执行用时:248 ms
- 内存消耗:40.8 MB
Python 实现
- 执行用时:36 ms
- 内存消耗:15.1 MB
C++ 实现
- 执行用时:4 ms
- 内存消耗:8.5 MB
性能对比
| 语言 | 执行用时 | 内存消耗 | 特点 |
|---|---|---|---|
| C# | 248 ms | 40.8 MB | 执行速度较慢,内存消耗较高 |
| Python | 36 ms | 15.1 MB | 执行速度适中,内存消耗适中 |
| C++ | 4 ms | 8.5 MB | 执行速度最快,内存消耗最低 |
代码亮点
- 🎯 使用哈希表记录已访问节点,避免重复克隆和无限递归
- 💡 递归实现DFS,代码简洁清晰
- 🔍 正确处理边界情况,如空图
- 🎨 使用函数式编程(C++中的lambda表达式)使代码更加简洁
常见错误分析
- 🚫 没有使用哈希表记录已访问节点,导致无限递归
- 🚫 没有正确处理空图的情况
- 🚫 只克隆节点而没有克隆边(邻居关系)
- 🚫 在BFS实现中,没有正确更新邻居关系
解法对比
| 解法 | 时间复杂度 | 空间复杂度 | 优点 | 缺点 |
|---|---|---|---|---|
| DFS(递归) | O(N + M) | O(N) | 实现简单,代码简洁 | 递归调用可能导致栈溢出 |
| DFS(迭代) | O(N + M) | O(N) | 避免递归调用栈溢出 | 实现稍复杂 |
| BFS | O(N + M) | O(N) | 按层次遍历,适合处理宽图 | 实现稍复杂 |
相关题目
- LeetCode 138. 复制带随机指针的链表 - 中等
- LeetCode 207. 课程表 - 中等
- LeetCode 210. 课程表 II - 中等
- LeetCode 332. 重新安排行程 - 中等
- LeetCode 1042. 不邻接植花 - 中等